[CRM & Sales Enablement, Data & CRM]
Operations Hub devenu Data Hub : nettoyer et automatiser sa data HubSpot avant l'IA

lecture : 10 min
13.11.2026
En septembre 2026, HubSpot a présenté sa version d'automne avec une phrase sans détour : « Nothing works right if your CRM is out of date », autrement dit rien ne fonctionne correctement si le CRM n'est pas à jour (Business Wire, Fall '26 Spotlight). La même annonce introduit un score qui mesure la complétude du contexte mis à disposition des agents. Un an plus tôt, à l'INBOUND 2025, l'éditeur avait remplacé Operations Hub par Data Hub.
Les deux annonces traitent du même problème.
Un agent IA, natif comme Breeze Customer Agent et Prospecting Agent ou externe comme Claude connecté au portail, lit les propriétés et les associations du CRM, puis agit à partir d'elles. Lorsqu'une même entreprise existe en trois exemplaires, l'agent résume un tiers de la relation. Lorsque le pays est saisi en texte libre, le segment « ETI industrielles en France » perd une partie des comptes concernés, et l'agent de prospection travaille sur une liste incomplète sans le signaler.
Cet article présente les outils de Data Hub (ex-Operations Hub) qui servent à remettre la donnée en état, l'ordre dans lequel nous les mobilisons et les automatisations qui empêchent la base de se dégrader à nouveau. Il porte sur les éditions Professional et Enterprise, et s'inscrit dans notre guide pour choisir, intégrer et exploiter un CRM.
Sommaire
- Operations Hub est devenu Data Hub : le périmètre en 2026
- Comment une donnée incohérente fausse le travail d'un agent
- Nettoyer : quatre chantiers, dans un ordre qui limite les erreurs irréversibles
- Automatiser pour que la base reste propre
- Une donnée propre permet à l'IA d'en produire de nouvelles
- Les limites et les coûts à connaître
- Par où commencer
- Cas client : définir les données clés avant d'automatiser
Operations Hub est devenu Data Hub : le périmètre en 2026
HubSpot présente Data Hub comme un Hub qui rassemble les données issues de sources externes et fournit des outils d'IA pour les connecter, les nettoyer et les exploiter. Le cœur historique d'Operations Hub est conservé :
- la synchronisation bidirectionnelle avec les autres applications (Data Sync) ;
- l'automatisation programmable, c'est-à-dire du code JavaScript ou Python exécuté comme action de workflow ;
- les outils de qualité des données et les datasets pour le reporting.
Les ajouts concernent surtout l'assemblage et la détection. Data Studio permet de combiner, dans une interface proche d'un tableur, des données issues de Google Sheets, de fichiers Excel ou d'entrepôts de données comme Snowflake (page produit Data Studio). La gestion des doublons gagne des règles de détection et de fusion personnalisables. L'édition Enterprise ajoute la connexion aux entrepôts et plateformes de stockage, les métriques avancées et le partage sécurisé de données (page produit Data Hub). Notre présentation des Hubs HubSpot situe Data Hub dans l'ensemble de la plateforme.
Le changement de nom corrige un malentendu fréquent. Beaucoup de directions lisaient « Operations » comme un outil réservé aux équipes opérations et l'écartaient des arbitrages de licences. « Data Hub » décrit plus clairement sa fonction.
Notre position est la suivante : pour une organisation qui prévoit de déployer des agents IA dans les douze prochains mois, Data Hub Professional relève du budget IA, et non du budget outillage. Les agents lisent la donnée que ce Hub maintient. Financer les agents sans financer la qualité de cette donnée revient à accepter des réponses fausses sur une partie des comptes.
Pour le budget, Data Hub Professional démarre à 720 € HT par mois et Enterprise à 2 000 € HT par mois, un siège inclus en facturation annuelle, d'après la grille détaillée dans notre guide des tarifs HubSpot 2026.
Comment une donnée incohérente fausse le travail d'un agent
Un agent ne vérifie pas la donnée qu'il lit. Il la traite comme une information fiable et produit une réponse formulée avec assurance, y compris lorsque la fiche est fausse ou incomplète. Les défauts de la base se retrouvent donc dans les réponses, dans les segments et dans les actions, sans signal d'alerte.
Trois défauts reviennent dans la plupart des reprises de portail que nous menons.
Les doublons d'entreprises. Les activités, les transactions et les tickets se répartissent sur deux ou trois fiches. Un agent qui prépare un rendez-vous ne voit qu'une fiche, donc qu'une partie de l'historique. Un agent de prospection peut contacter un compte déjà client. Une cause est documentée par HubSpot elle-même : la déduplication automatique par nom de domaine ne s'applique pas aux entreprises créées par l'API (base de connaissances HubSpot). Chaque intégration qui crée des entreprises sans rechercher d'abord une fiche existante produit donc des doublons, en continu et sans erreur visible.
Les formats hétérogènes. « France », « FR », « france » et « Fr. » dans la même propriété texte ; des fonctions saisies librement ; des numéros de téléphone avec et sans indicatif. Les filtres des segments, et donc les critères de ciblage des agents, portent sur des valeurs exactes. Une valeur mal orthographiée exclut la fiche.
Les propriétés concurrentes. Trois propriétés « Secteur » créées à des époques différentes, dont une seule est encore alimentée. Un humain sait laquelle consulter. Un agent, ou Claude interrogé par un commercial avec ses propres droits, peut lire la mauvaise.
Une partie de ces défauts tient au choix du prestataire. Une synchronisation mise en service sans clé d'unicité ni règle de priorité entre les deux systèmes fonctionne pendant des mois avant que les doublons deviennent visibles. Ce type d'erreur relève moins de la compétence technique que de l'adéquation : un intégrateur qui configure un connecteur sans connaître le projet de données de l'entreprise n'a pas les éléments pour choisir la bonne clé. Chez Markentive, chaque synchronisation est documentée avec sa clé d'unicité, son sens de priorité et son propriétaire avant la mise en production.
Nettoyer : quatre chantiers, dans un ordre qui limite les erreurs irréversibles
L'ordre compte davantage que l'outil. Nous classons les chantiers selon un critère simple : une erreur commise à l'étape N doit pouvoir être corrigée avant l'étape N+1. La fusion de doublons, qui ne se défait pas, arrive donc après la normalisation, qui se rejoue sans risque.
| Chantier | Outil Data Hub | Édition requise | Réversible |
|---|---|---|---|
| 1. Trancher les propriétés de référence | Vue d'ensemble de la qualité des données, gestion des propriétés | Data Hub Professional ou Enterprise | Oui (archivage) |
| 2. Normaliser les formats | Action de workflow « Format data » | Data Hub Professional ou Enterprise | Oui, si la valeur d'origine est conservée |
| 3. Dédoublonner | Gestionnaire des doublons, règles personnalisées | Data Hub Professional ou Enterprise pour le traitement en masse | Non |
| 4. Fermer les entrées | Propriétés à valeur unique, règles d'import, intégrations | Selon le Hub | Oui |
1. Trancher les propriétés de référence
Avant de corriger une valeur, il faut décider quelle propriété fait foi. Pour chaque information utile aux agents (secteur, pays, effectif, statut client, propriétaire), une seule propriété de référence, un format attendu et un responsable. Les propriétés concurrentes sont archivées après report de leurs valeurs utiles. Ce chantier est le moins technique et le plus souvent sauté.
2. Normaliser les formats
L'action de workflow « Format data », dans la section Data ops du panneau d'actions, couvre l'essentiel des corrections courantes : casse, espaces superflus, balises HTML, remplacement de caractères, format de date, arrondi. Une vingtaine d'options sont proposées, et un mode personnalisé accepte des formules, par exemple pour retirer tirets et astérisques d'un numéro de téléphone (base de connaissances HubSpot). Elle requiert Data Hub Professional ou Enterprise.
Nous écrivons d'abord le résultat dans une propriété temporaire, comparons un échantillon, puis seulement remplaçons la valeur d'origine.
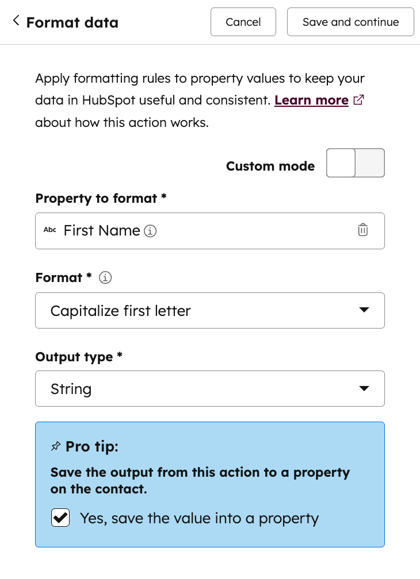
Paramétrage de l'action « Format data » dans un workflow. Source : base de connaissance HubSpot
3. Dédoublonner
Le gestionnaire des doublons compare chaque jour les valeurs des propriétés pour proposer des paires probables : prénom, nom, email, téléphone, code postal, nom d'entreprise pour les contacts ; domaine, nom, pays, téléphone et secteur pour les entreprises (base de connaissances HubSpot). La normalisation de l'étape précédente améliore donc directement la qualité des paires proposées.
Les éditions Professional de n'importe quel Hub permettent de traiter les doublons un par un. Data Hub Professional ou Enterprise ajoute le traitement en masse (jusqu'à 30 000 paires en Professional, 100 000 en Enterprise), les règles de détection personnalisées (deux par objet, neuf propriétés chacune), les règles de fusion qui fixent la valeur conservée propriété par propriété, et le journal d'audit.
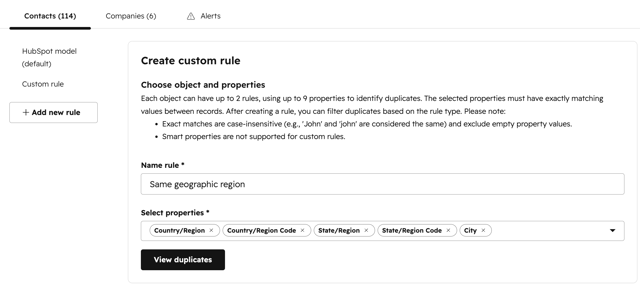
Création d'une règle personnalisée de détection des doublons. Source : base de connaissance HubSpot
Une règle ne connaît pas d'exception : une fusion ne peut pas être annulée. Nous ne fusionnons jamais en masse avant d'avoir vérifié les règles sur quelques centaines de paires, et nous paramétrons les règles de fusion avant la première fusion, pas après.
4. Fermer les entrées
Un nettoyage qui ne traite pas les sources de pollution est à refaire quelques mois plus tard. Trois portes sont à fermer : les propriétés à valeur unique (jusqu'à dix par objet) pour les identifiants comme un numéro SIREN ou un identifiant ERP ; les règles appliquées aux imports et aux formulaires ; les intégrations qui créent des fiches par l'API, à reconfigurer pour rechercher une fiche existante avant toute création.
Automatiser pour que la base reste propre
Une fois la base remise en état, l'objectif change : chaque nouvelle fiche doit arriver au bon format sans intervention humaine.
Les workflows de maintenance sont déclenchés par la création d'une fiche ou par la modification d'une propriété suivie. Ils appliquent « Format data », renseignent une valeur par défaut lorsque le champ est vide, et créent une tâche pour le propriétaire lorsque la correction exige un jugement humain (un secteur ambigu, une entreprise sans domaine).
Lorsque l'action native ne suffit pas, l'automatisation programmable prend le relais : une action de code personnalisé peut comparer une valeur à un référentiel interne, interroger l'API d'un outil métier ou calculer une clé de rapprochement. Notre règle sur ce point : chaque action de code a un propriétaire nommé et une documentation, faute de quoi elle devient une dette que personne n'ose modifier. Nous la réservons aux cas où aucune action native ne convient.
Un incident fréquent mérite d'être anticipé. Un workflow qui reformate une propriété peut entrer en conflit avec une synchronisation qui réécrit la valeur d'origine depuis l'autre système, et les deux se corrigent mutuellement à chaque passage. La parade consiste à définir, dans la synchronisation, quel système fait foi pour chaque champ, avant d'activer le workflow.
Pour le reporting, Data Studio et les datasets assemblent des données de plusieurs sources sans les dupliquer dans le CRM. Les crédits HubSpot sont consommés lorsque les données sont synchronisées hors de Data Studio ; les autres fonctionnalités de Data Hub sont incluses dans l'abonnement (FAQ de la page produit Data Hub).
L'accompagnement de notre équipe SalesOps & Data porte précisément sur ces deux temps : la remise en état, puis les automatisations et la gouvernance qui la font durer.
Une donnée propre permet à l'IA d'en produire de nouvelles
Une base remise en état rend possibles deux usages de l'IA qui créent de la donnée exploitable, à condition que la base sur laquelle ils s'appuient soit fiable.
Des propriétés calculées à partir de la matière non structurée
Le CRM contient beaucoup d'informations qui ne sont dans aucune propriété : transcriptions d'appels, emails, notes de réunion. Les smart properties du Data agent répondent à une question métier posée sur chaque compte (« Le compte utilise-t-il un ERP SAP ? », « Quelle priorité le client a-t-il exprimée lors du dernier échange ? ») à partir de ces sources et du web, et écrivent la réponse sur la fiche selon une fréquence de rafraîchissement définie. HubSpot les facture 0,10 $ par réponse en crédits (page produit Data agent).
L'intérêt est de brancher les workflows et la personnalisation sur une propriété structurée plutôt que sur du texte libre, comme nous le détaillons dans notre article sur les workflows de marketing automation B2B. Nos garde-fous : une propriété calculée n'est jamais modifiée à la main (une propriété distincte existe pour la correction humaine), elle est datée, et tout workflow qui s'en sert prévoit une branche par défaut pour les valeurs vides.
Un enrichissement externe ciblé
Le second usage complète la fiche avec des informations extérieures : effectif, technologies, actualité, signaux d'intention, et surtout les changements de poste, déclencheur commercial le plus rentable et le plus négligé. Le Data agent facture le suivi de l'intention d'achat 0,10 $ par entreprise et par mois, les signaux personnalisés 0,50 $. Ces montants se multiplient vite : nous enrichissons un segment défini, jamais la base entière. Notre article sur l'enrichissement de données CRM avec Breeze détaille les règles à poser pour ne pas polluer la base.
Une limite demeure : une propriété générée n'est pas une propriété exacte. Un contrôle sur échantillon reste nécessaire avant de lui confier une décision de routage ou de priorité.
Les limites et les coûts à connaître
- La fusion est définitive. HubSpot l'écrit dans sa documentation : un enregistrement fusionné ne peut pas être restauré.
- La détection « par IA » des doublons reste peu documentée. La page produit évoque une IA qui identifie les doublons avec plus de précision et peut fusionner automatiquement selon vos préférences. La base de connaissances mentionne un « modèle » de détection et un score de similarité, sans en préciser le fonctionnement ni le paramétrage de la fusion automatique. Nous la traitons comme une aide au tri, pas comme une décision.
- Les volumes de traitement en masse sont plafonnés à 30 000 paires en Professional et 100 000 en Enterprise. Un portail de plusieurs centaines de milliers de contacts avec dix ans d'historique se traite en plusieurs passes.
- Les crédits s'additionnent. Synchronisations hors de Data Studio, smart properties, signaux : chaque usage est modeste, leur cumul sur une base mal ciblée ne l'est pas.
- Un score de complétude ne mesure pas l'exactitude. Le score de contexte annoncé à l'automne 2026 indique quelles informations manquent. Une fiche entièrement remplie de valeurs obsolètes obtient un bon score.
- Data Hub ne désigne pas de responsable. L'outil détecte et corrige ; il ne décide pas qui tranche entre deux valeurs contradictoires.
Par où commencer
Une seule séquence, dans cet ordre :
- Choisir le premier cas d'usage IA visé (réponse au support, préparation de rendez-vous, prospection) et lister les objets et propriétés qu'il lit. Le périmètre du nettoyage se déduit de cette liste, pas de l'ensemble du portail. Notre Diagnostic IA-Ready aide à situer ce cas d'usage et ses prérequis bloquants.
- Trancher les propriétés de référence de ce périmètre et archiver les concurrentes.
- Normaliser avec « Format data », valeur d'origine conservée.
- Dédoublonner, règles testées sur échantillon avant tout traitement en masse.
- Fermer les entrées et activer les workflows de maintenance.
- Ouvrir l'agent, d'abord en lecture, puis ajouter les smart properties et l'enrichissement sur un segment.
La principale limite de cette méthode tient à sa durée de vie. Un portail nettoyé se dégrade de nouveau si personne n'est chargé de le maintenir : la qualité des données suppose un responsable désigné et un temps récurrent, au même titre que le pilotage des campagnes.
Cas client : définir les données clés avant d'automatiser
L'accompagnement de La Poste Solutions Business a commencé par un cadrage stratégique pour clarifier les objectifs et identifier les données clés, dans un contexte d'outils qui ne communiquaient pas entre eux. Les formulaires, les workflows et le scoring sont venus ensuite, puis l'intégration de HubSpot aux outils internes. Résultats publiés : quatre fois plus de nouveaux contacts générés, 3,5 fois plus de leads transmis aux équipes commerciales et 82 % d'opportunités supplémentaires générées par le marketing.
Pour aller plus loin
- CRM : choisir, intégrer, exploiter : le guide du cluster, pour replacer la qualité des données dans l'ensemble du projet CRM.
- Enrichissement de données CRM avec Breeze : les règles pour enrichir une base sans la polluer, une fois le nettoyage fait.
- Connecter Claude à HubSpot sans perdre la main sur vos données : les droits et les usages à ouvrir en premier lorsqu'un assistant externe lit le CRM.
- Diagnostic IA-Ready : treize questions pour savoir si votre HubSpot est prêt pour les agents IA.